Szkennelt PDF kereshetővé tétele OCR-rel lépésről lépésre
Frissítve: 2026. október 2.
Egy szkennelés az oldal képe: nem lehet benne keresni, szót kijelölni, sort másolni. Az OCR - kereshető PDF leolvassa a szavakat a képről, és egy láthatatlan szövegréteget tesz fölé, szóról szóra a helyükön. Az oldal pontosan úgy néz ki, mint előtte, de már kereshetsz benne, kijelölhetsz és másolhatsz. A felismerés a böngésződben fut, a szkennelés nem töltődik fel.
Ingyen kipróbálható, regisztráció nélkül - a fájljaid nem hagyják el az eszközödet.
Röviden
- Húzd a szkennelt PDF-eket az oldalra, vagy nyomd meg a Fájlok hozzáadása gombot.
- Hagyd bekapcsolva a Nyelv felismerése beállítást - vagy válaszd ki magad a dokumentum nyelveit.
- Nyomd meg a Szöveg felismerése gombot, és várd meg, amíg az oldalakat beolvassa.
- A kereshető PDF azonnal az eszközödre mentődik.
A szkennelések hozzáadása
Ejtsd a PDF-eket bárhová az oldalon, vagy nyomd meg a Fájlok hozzáadása gombot. Érkezéskor minden fájlban megkeressük a szöveg nélküli oldalakat - a fájllista megmondja, hány ilyen van, és a beolvasandó oldalak kiemelve jelennek meg. Ha egy fájlban már van szöveg, azt is jelezzük, milyen nyelvű.
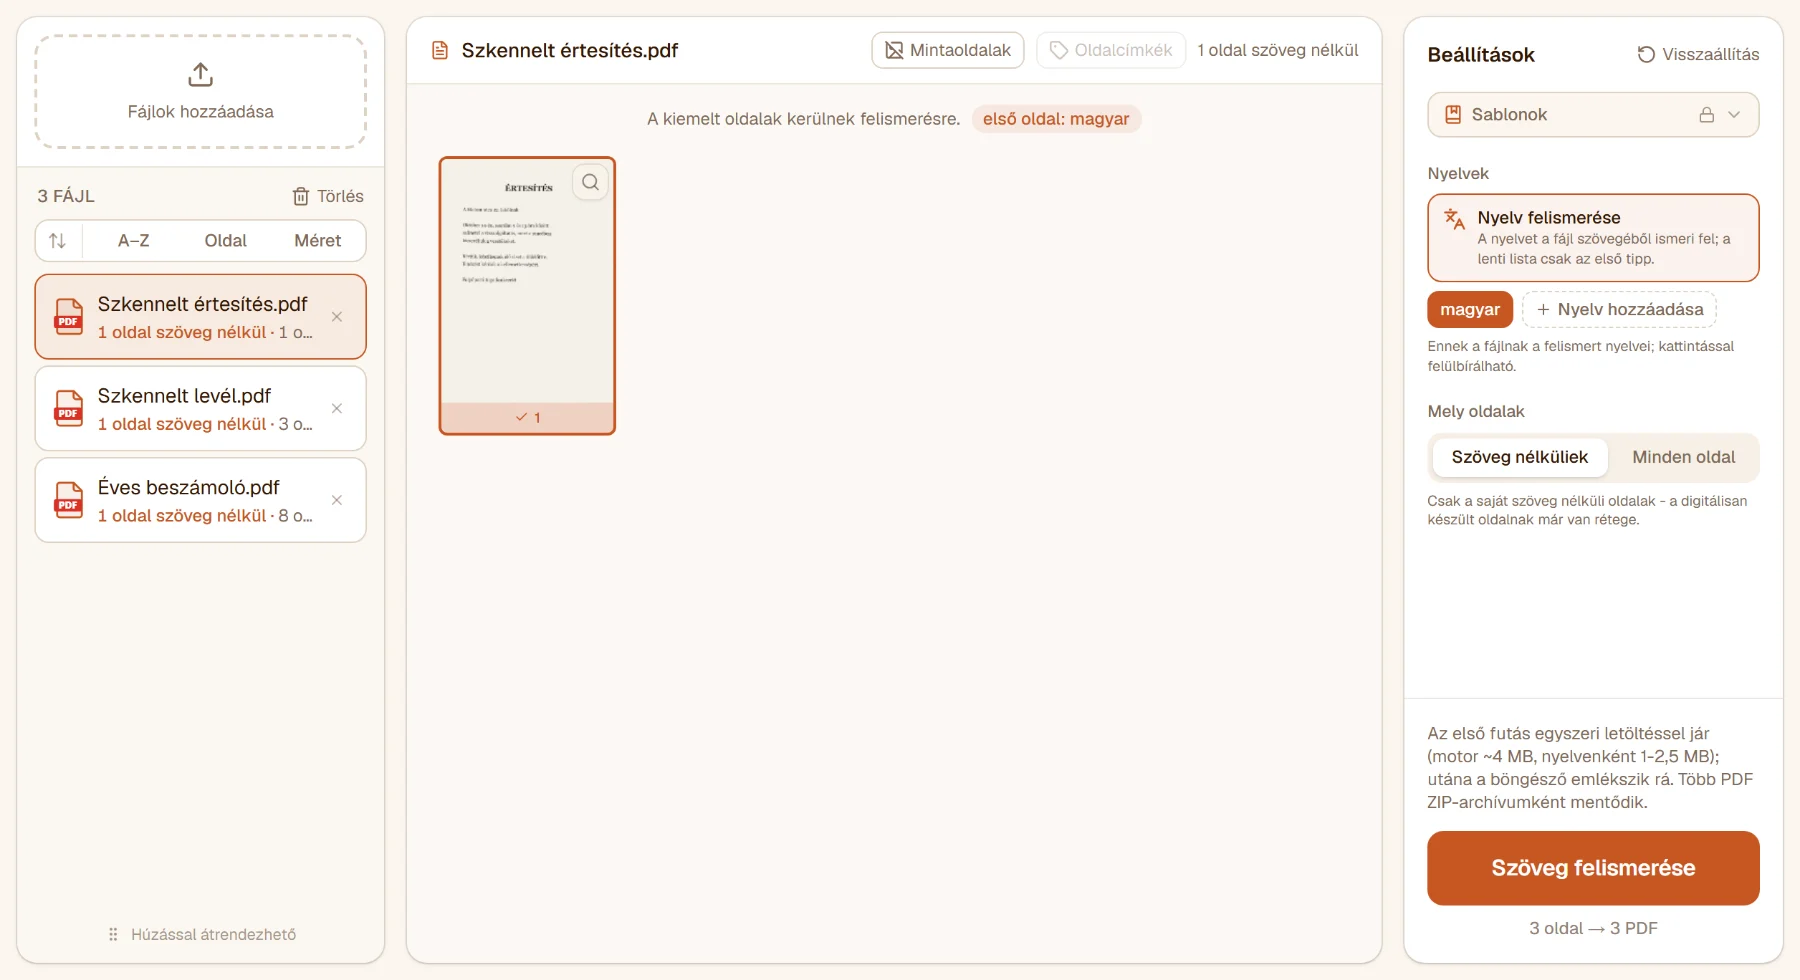
Egy teljesen szöveg nélküli szkennelésnél az eszköz gyorsan beolvassa az első oldalt, hogy kitalálja a nyelvet („első oldal: magyar” az oldalképek felett), és a nyelvi címkék ezt követik.
Nyelvek
- Nyelv felismerése (alapból bekapcsolva) - minden oldalt a saját szavai alapján ítélünk meg, és egy kétnyelvű dokumentumot mindkét nyelven olvasunk. A címkék a kijelölt fájl tippjét mutatják; egy kattintással felülbírálhatod.
- Nyelv hozzáadása - az eszköz 40 nyelve közül választhatsz, a latin, a cirill, a görög, az arab, a héber, valamint a kínai, japán és koreai írást is beleértve.
- Ha kikapcsolod a felismerést, minden oldalt pontosan a kiválasztott nyelvekkel olvasunk.
Az első futtatás letölti a felismerő motort (kb. 4 MB) és a nyelvi adatokat (nyelvenként 1-2,5 MB) - a saját oldalunkról, soha nem harmadik féltől. A böngésző megjegyzi őket, így a következő futtatás azonnal indul.
Mely oldalak?
A Mely oldalak alapból Szöveg nélküliek: csak azokat az oldalakat olvassuk be, amelyeknek nincs saját szövegük - a számítógépen készült oldalnak már megvan a szövege, és egy második réteg megduplázná a keresési találatokat. A Minden oldal egy rosszul felismert szkennelést olvas be újra; a régi rétege alatta marad.
Felismerés és mentés
Nyomd meg a Szöveg felismerése gombot. Az oldalképek feletti sor és a gomb oldalról oldalra mutatja a haladást. Amikor kész, a kereshető PDF azonnal az eszközödre mentődik, a fájllista pedig megmutatja, hány szót talált és milyen nyelven.
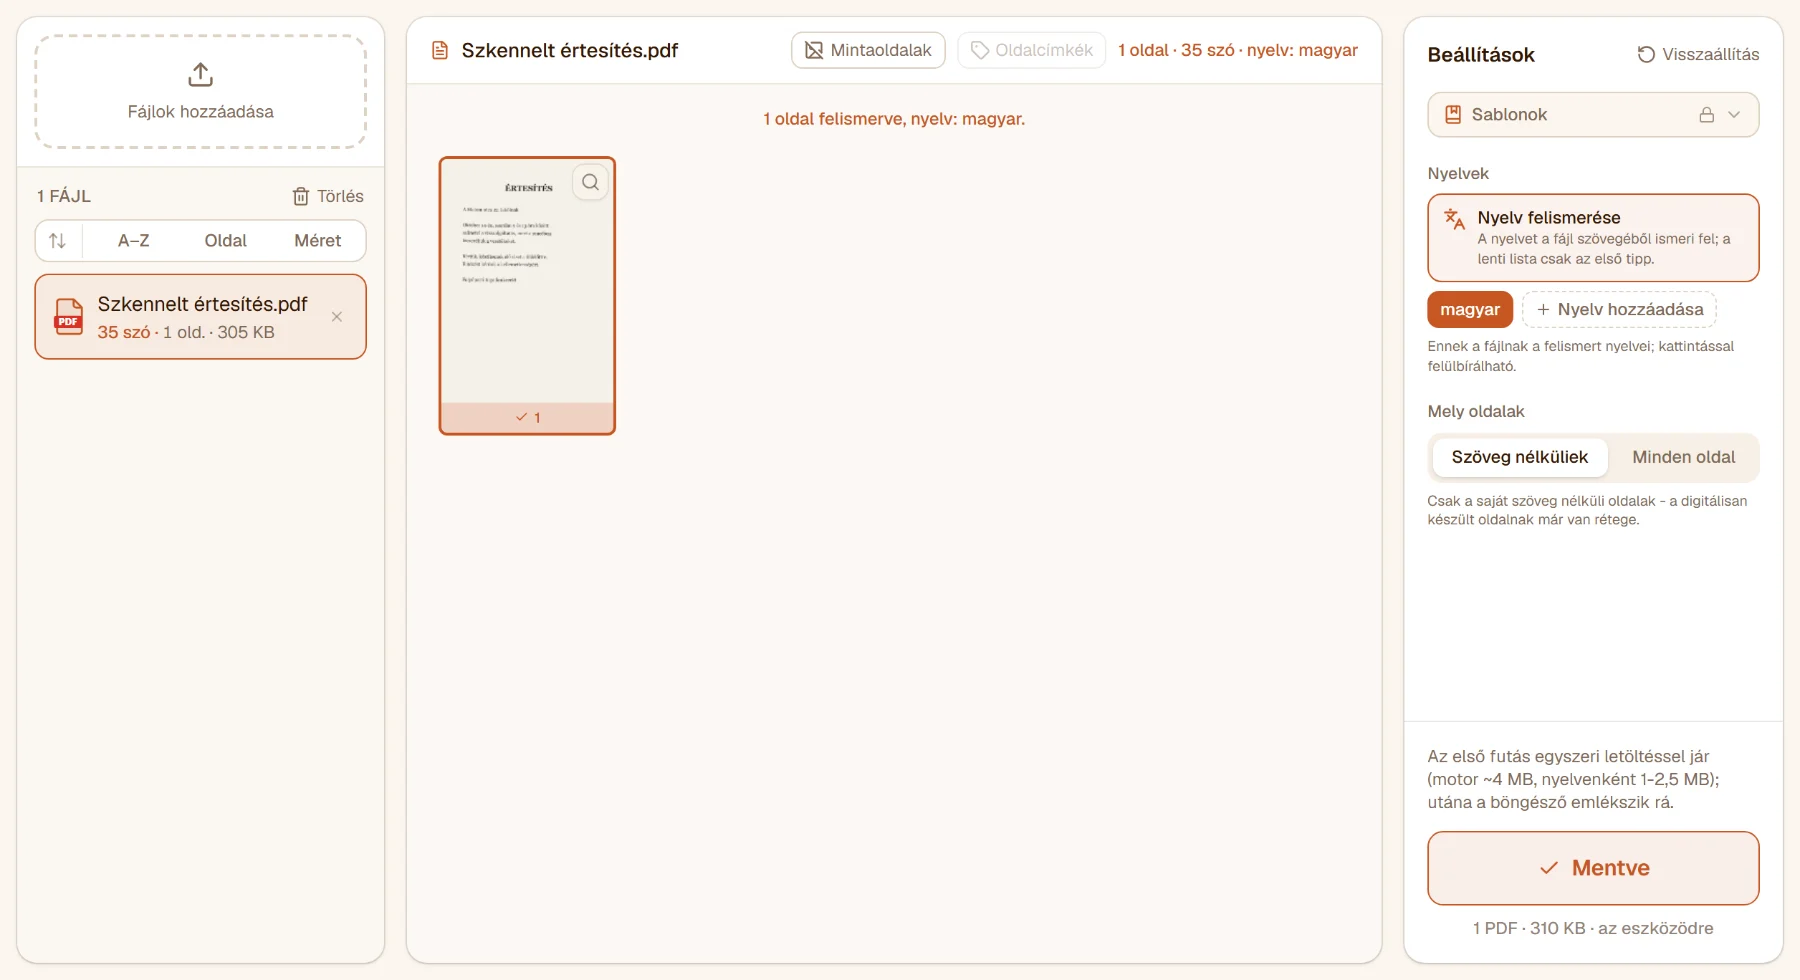
Nyisd meg az eredményt bármilyen PDF-olvasóban, és keress rá egy szóra: megtalálja, és a szkennelt képen kiemeli. A motor által bizonytalannak ítélt szavakat is elhelyezzük - a keresésnek szüksége van rájuk -, és az eredmény bizonytalanként számolja őket.
Így lesz jó az eredmény
- Ha teheted, 300 dpi-vel szkennelj. 150 dpi alatt az eszköz figyelmeztet, hogy hibákra számít - csak azt tudja leolvasni, ami a képen van.
- Egy ferde szkennelés kiegyenesítve jobban olvasható: a PDF kiegyenesítése előbb egyenesbe állítja.
- Oldalra fordulva vagy fejjel lefelé szkennelt oldalak? A PDF automatikus elforgatása felállítja őket.
Korlátok
Fiók nélkül és ingyenes fiókkal egy futtatásban két fájlt ismertethetsz fel, egyenként legfeljebb 15 MB-osat. Pro előfizetéssel nincs korlát sem a fájlok számára, sem a méretére, és a nyelveket és az oldalválasztást sablonként is elmentheted. Minden oldalt a saját gépeden olvasunk be, így egy hosszú dokumentum annyi ideig tart, amennyi időre a gépednek szüksége van.
És utána?
- A felismert szöveget Wordben szerkesztenéd? PDF → Word.
- Csak a szöveg kell, .txt-ként? PDF → szöveg.
- Túl nagy a szkennelés az elküldéshez? PDF tömörítés.
Kipróbálod?
Ingyen kipróbálható, regisztráció nélkül - a fájljaid nem hagyják el az eszközödet.
További útmutatók
- PDF fájlok összefűzése lépésről lépésrePDF-ek, képek és Office-fájlok egyetlen PDF-be fűzése a böngészőben: sorrend, elválasztó lapok, tartalomjegyzék, könyvjelzők és kétoldalas szkennelés összefésülése.
- PDF szétvágása több fájlra lépésről lépésrePDF darabolása a böngészőben: a választott oldalaknál, N oldalanként, egyenlő részekre, oldalanként külön fájlba, vagy e-mailhez elég kicsi részekre.
- PDF oldalainak elforgatása lépésről lépésrePDF oldalainak forgatása a böngészőben: egy vagy több oldal, negyed fordulattal vagy tetszőleges szögben, akár több fájlban egyszerre - és úgy mentve, hogy elforgatva maradjon.
- PDF oldalainak tükrözése lépésről lépésrePDF oldalainak tükrözése vízszintesen vagy függőlegesen a böngészőben - hátulról szkennelt fólia, tükörírással nyomtatandó lap - egy oldalra, többre vagy akár több fájlra egyszerre.
- Ferde szkennelt PDF kiegyenesítése lépésről lépésreFerdén beolvasott PDF oldalainak kiegyenesítése a böngészőben: minden oldal dőlését külön megmérjük és helyben javítjuk, ahol kell, kézzel állított szöggel.
- PDF oldalainak automatikus talpra állítása lépésről lépésreEgy szkennelt PDF oldalra dőlt és fejjel lefelé álló oldalainak megkeresése és talpra állítása a böngészőben - oldalanként felismerve, az oldalképeken ellenőrizve, veszteség nélkül mentve.
- Oldalak törlése PDF-ből lépésről lépésreOldalak eltávolítása PDF-ből a böngészőben: jelöld meg őket az oldalképeken, számmal vagy gyorsválasztóval, például minden páros oldalt - egy vagy több fájlban, feltöltés nélkül.
- PDF oldalméretének módosítása lépésről lépésreEgy PDF minden oldala A4-re, Letterre, A3-ra, A5-re vagy egyedi méretre a böngészőben, vagy a tartalom kicsinyítése a saját oldalán - a vektoros szöveg éles marad, a hivatkozások és űrlapmezők a helyükön.
- PDF oldalak átrendezése lépésről lépésrePDF oldalainak új sorrendje a böngészőben: oldalképek húzása, a kijelöltek az elejére, a végére vagy bármelyik oldal elé, vagy a sorrend megfordítása - feltöltés nélkül.
- PDF oldalsorrendjének megfordítása lépésről lépésreEgy PDF oldalsorrendjének megfordítása a böngészőben - egy az utolsó oldallal kezdve beolvasott szkennelés, vagy csak a kiválasztott oldalak -, egy vagy több fájlban egyszerre.
- Oldalak kinyerése PDF-ből lépésről lépésreA szükséges oldalak kimásolása egy vagy több PDF-ből a böngészőben: oldalképeken vagy számmal kiválasztva, egy PDF-be, fájlonként, tartományonként vagy oldalanként mentve.
- PDF vágása: a margók levágása lépésről lépésrePDF oldalainak fehér margói levágva a böngészőben, vagy egy általad rajzolt keretre vágva - egy keret minden oldalra, külön a páratlan és páros oldalaknak, vagy oldalanként.
- Több PDF-oldal egy lapon és füzet készítése lépésről lépésre2, 4, 6, 8, 9 vagy 16 PDF-oldal egy lapra rendezve, vagy egy PDF hajtogatható füzetként a böngészőben - a lapok előnézete pontosan olyan, ahogy mentődnek, a szöveg éles marad.
- PDF szerkesztése: szöveg átírása, szöveg, kép, táblázat és oldalak hozzáadása lépésről lépésrePDF szerkesztése a böngészőben, mint egy szövegszerkesztőben: a dokumentum saját bekezdéseinek átírása, kijelölés formázása, szövegdobozok, képek, alakzatok, táblázatok, hivatkozások, megjegyzések és űrlapmezők, oldalak hozzáadása és törlése, keresés és csere. Semmi nem töltődik fel.
- PDF aláírása online: lépésről lépésrePDF aláírása a böngészőben: rajzold, gépeld vagy töltsd be az aláírásodat, helyezd el az oldalon, adj hozzá második aláírót, tedd minden oldalra - semmi nem töltődik fel.
- PDF űrlap kitöltése lépésről lépésreGépelés egy PDF űrlap mezőibe közvetlenül az oldalon, a böngészőben - szöveg, jelölőnégyzet, lista, választás -, aztán mentés kitöltve, vagy véglegesítve, hogy senki ne írhassa át.
- Vízjel hozzáadása PDF-hez lépésről lépésreSzöveges vagy logós vízjel a PDF oldalaira a böngészőben: átlósan vagy sarokban, az oldalon ismételve, tetszőleges mérettel és átlátszósággal - feltöltés nélkül.
- Oldalszámozás PDF-ben: lépésről lépésrePDF oldalainak számozása a böngészőben: oldalak, pozíció és margó kiválasztása, a borító kihagyása, tetszőleges kezdőszám, „3. oldal / 12” saját stílusban.
- PDF metaadatainak módosítása vagy törlése lépésről lépésreEgy PDF címének, szerzőjének, tárgyának, kulcsszavainak, alkalmazásának és létrehozási dátumának szerkesztése a böngészőben - vagy mindegyik törlése, mielőtt a fájl kikerül a házból -, úgy írva, hogy minden megjelenítő ugyanazt mutassa.
- PDF lapítása lépésről lépésreEgy PDF űrlapmezőinek, megjegyzéseinek, kiemeléseinek és bélyegzőinek beleégetése az oldalba a böngészőben - vagy eltávolításuk -, hogy a fájl minden megjelenítőben ugyanúgy nézzen ki, és többé ne lehessen módosítani.
- Két PDF-változat összehasonlítása lépésről lépésreMi változott egy PDF két változata között - a törölt, beszúrt és módosított szavak a két oldalon egymás mellett jelölve, megőrizhető jelentéssel, a böngészőben. Semmi nem töltődik fel.
- PDF méretének csökkentése: tömörítés lépésről lépésrePDF tömörítése a böngészőben: tömörítési szint, méret előtte és utána, több fájl egyszerre - a szöveg éles marad, semmi nem töltődik fel.
- PDF gyors megnyitása weben (gyors webes megjelenítés) lépésről lépésrePDF linearizálása a böngészőben, hogy az olvasó már akkor mutassa az első oldalt, amikor a többi még töltődik - weboldalról vagy linkről kiszolgált PDF-hez. Az oldalak pontosan ugyanazok maradnak.
- Rejtett adatok eltávolítása PDF-ből lépésről lépésreAmi egy PDF-ben az oldalak mellett lapul - metaadatok, csatolt fájlok, beágyazott videó, szkriptek, megjegyzések, bélyegképek - eltávolítva a böngészőben, mielőtt a dokumentum kikerül a házból. Az oldalak változatlanok maradnak.
- Sérült, meg nem nyíló PDF javítása lépésről lépésreOlyan PDF megjavítása a böngészőben, amit az olvasó nem hajlandó megnyitni - félbeszakadt letöltés, hibás tartalomjegyzékű fájl. Minden fájlt érkezéskor ellenőrzünk, és látod, mi volt a baj, és mi jött vissza.
- Mi van egy PDF-ben? Elemzés lépésről lépésrePDF elemzése a böngészőben: az oldalai és méreteik, mitől nagy, a képei és azok felbontása, a betűtípusai, a benne lapuló rejtett adatok - és hogy melyik eszköz segít tovább. Semmi nem töltődik fel.
- Üres oldalak eltávolítása PDF-ből lépésről lépésreEgy kétoldalas szkennelés üres oldalainak felismerése és törlése a böngészőben: minden oldalt megmérünk, az üreseket ellenőrzésre megjelöljük, a szkenner sötét szélét figyelmen kívül hagyjuk.
- Ismétlődő oldalak eltávolítása PDF-ből lépésről lépésreA korábbi oldalt megismétlő lapok - kétszer beszkennelt lap, újra összefűzött csatolmány - megkeresése és törlése a böngészőben, miután az oldalképeken minden jelölést átnéztél.
- PDF kitakarása: nevek és számok végleges eltávolításaNevek, e-mail-címek, telefon- és számlaszámok kitakarása PDF-ben a böngészőben - a tartalom törlődik a fájlból, nem csak eltakarjuk. Kereséssel, mintákkal vagy húzással.
- PDF jelszavas védelme lépésről lépésreJelszó egy PDF-re a böngészőben, AES-256 titkosítással, és annak beállítása, hogy az olvasó nyomtathat, szerkeszthet vagy másolhat-e - a fájl és a jelszó nem hagyja el az eszközödet.
- Jelszó eltávolítása PDF-ről lépésről lépésrePDF feloldása a böngészőben: a jelszó levétele egy olyan fájlról, amelynek ismered a jelszavát, vagy a nyomtatást és másolást tiltó korlátozások feloldása - feltöltés nélkül.
- PDF digitális aláírásának ellenőrzése lépésről lépésreEllenőrizd a böngészőben, hogy egy PDF digitális aláírásai épek-e, ki és mikor írta alá, szerepel-e a szolgáltató az EU bizalmi listáin - és ha a fájl azóta megváltozott, kapd meg az aláírt változatot. Semmi nem töltődik fel.
- PDF digitális aláírása tanúsítvánnyal lépésről lépésrePDF aláírása a tanúsítványoddal (.p12 / .pfx) a böngészőben, vagy egy helyben készülővel - valódi digitális aláírás, amely igazolja, hogy a dokumentum azóta nem változott. Ingyenes, semmi nem töltődik fel.
- Képekből PDF készítése lépésről lépésrePDF készítése JPG-, PNG- és más fotókból a böngészőben: sorrend, oldalméret és margó, oldalanként egy kép vagy több egy lapon.
- PDF oldalak mentése JPG vagy PNG képként lépésről lépésrePDF oldalainak mentése JPG, PNG vagy WebP képként a böngészőben: oldalak, formátum, minőség és felbontás választása - feltöltés nélkül.
- Képek kinyerése PDF-ből lépésről lépésreEgy PDF-be ágyazott minden kép kimentése JPG vagy PNG fájlként a böngészőben - a JPEG pontosan a fájlban lévő JPEG-ként jön ki, újabb minőségromlás nélkül; az ikonok és vonalak kihagyhatók.
- PDF szürkeárnyalatossá alakítása lépésről lépésreSzínes PDF fekete-fehérré alakítása a böngészőben nyomtatáshoz vagy archiváláshoz - a szöveg éles és kijelölhető marad, a képek és színátmenetek szürkék lesznek, semmi nem töltődik fel.
- PDF szövegének kinyerése .txt fájlba lépésről lépésreEgy PDF szövegének mentése sima .txt fájlként a böngészőben - újratördelődő bekezdésekként vagy soronként, ahogy az oldalon áll -, néhány vagy minden oldalról, mentés előtt a képernyőn látható előnézettel.
- PDF átalakítása Word-dokumentummá lépésről lépésrePDF-ből szerkeszthető Word-dokumentum a böngészőben: az oldal úgy, ahogy kinéz, vagy a szöveg bekezdésekben, sorokban - te választod ki az oldalakat, semmi nem töltődik fel.
- PDF táblázatainak átalakítása Excellé lépésről lépésreEgy PDF táblázatainak átalakítása Excel-munkafüzetté (.xlsx) a böngészőben - a számok valódi, összeadható számként, a táblázatok mentés előtt a képernyőn ellenőrizve.
- PDF átalakítása PowerPointtá lépésről lépésreEgy PDF minden oldala PowerPoint-dia (.pptx) a böngészőben - a dia úgy néz ki, mint az oldal, és minden szó szerkeszthető szöveg marad, a saját szövegdobozában.
- Word-dokumentum átalakítása PDF-fé lépésről lépésreWord-dokumentumok (.docx) PDF-fé alakítása a böngészőben - a szöveg, a listák, a táblázatok, a képek, az élőfej és élőláb megmarad, több dokumentum egyszerre, feltöltés nélkül.
- Excel-munkafüzet átalakítása PDF-fé lépésről lépésreExcel-munkafüzet (.xlsx) átalakítása PDF-fé a böngészőben, minden munkalap úgy tördelve, ahogy az Excel nyomtatná - Excel nélkül, feltöltés nélkül.
- PowerPoint-bemutató átalakítása PDF-fé lépésről lépésrePowerPoint-bemutató (.pptx) átalakítása PDF-fé a böngészőben, diánként egy oldal a dia méretében - PowerPoint nélkül, feltöltés nélkül.